AI-forskning · 4 november 2026
En språkmodell lagade en annan modell genom att skriva om vikterna
Johan Öhman Saldes
Forskare vid MIT gav GPT-6 Astra vikterna i en liten språkmodell som fastnade i loopar när den räknade matte. Astra ändrade en bråkdel av vikterna utan någon träning, och modellens resultat på MATH-500 steg från knappt 8 till drygt 48 %. Det kan vara en av årets viktigaste AI-studier, kanske en av de viktigaste på flera år.
Studien visar att frontiermodeller som GPT-6 Astra kan förstå vad som händer inuti en annan modell genom att läsa dess vikter. Det kan hjälpa oss att förstå hur AI fungerar inuti, något som hittills har varit en svart låda. Och Astra kan dessutom ändra vikterna i en annan modell med kirurgisk precision, så att den blir mycket bättre.
Resultaten kommer från ett forskningsinlägg av Rikiya Takehi, Jayden Teoh, Alex Zhang och Omar Khattab vid MIT CSAIL, publicerat den 2 november 2026. Det är inte granskat av andra forskare, och författarna kallar själva resultaten mycket tidiga.
Så fungerar en AI-modell
Moderna AI-modeller är neurala nätverk, och ett neuralt nätverk är i grunden miljontals eller miljardtals tal. De kallas vikter. Hur talen förhåller sig till varandra avgör hur modellen behandlar information. När du ställer en fråga till ChatGPT räknas frågan igenom miljarder, kanske biljoner, av de här talen tills modellen kommer fram till ett svar.
Vikterna får sina värden genom träning med gradient descent. Det är i princip försök och misstag i stor skala: en algoritm justerar talen om och om igen så att felen i svaren blir färre. Metoden ger en fungerande modell men ingen förklaring. Vi kan inte se varför vikterna har de värden de har, hur de hänger ihop eller hur de påverkar svaret. Modellen är en svart låda.
Vad weight space programming är
De senaste åren har vi använt språkmodeller för att förbättra text, kod och promptar. Vi pekar modellen mot en kodbit och ber den förbättra koden. Den provar olika varianter, ser vilken som fungerar bäst och väljer den. Men det har inte funnits något motsvarande sätt att peka en språkmodell mot vikterna. Där har vi i stället haft en fast algoritm, gradient descent, som minskar felen utan att någon faktiskt läser vikterna.
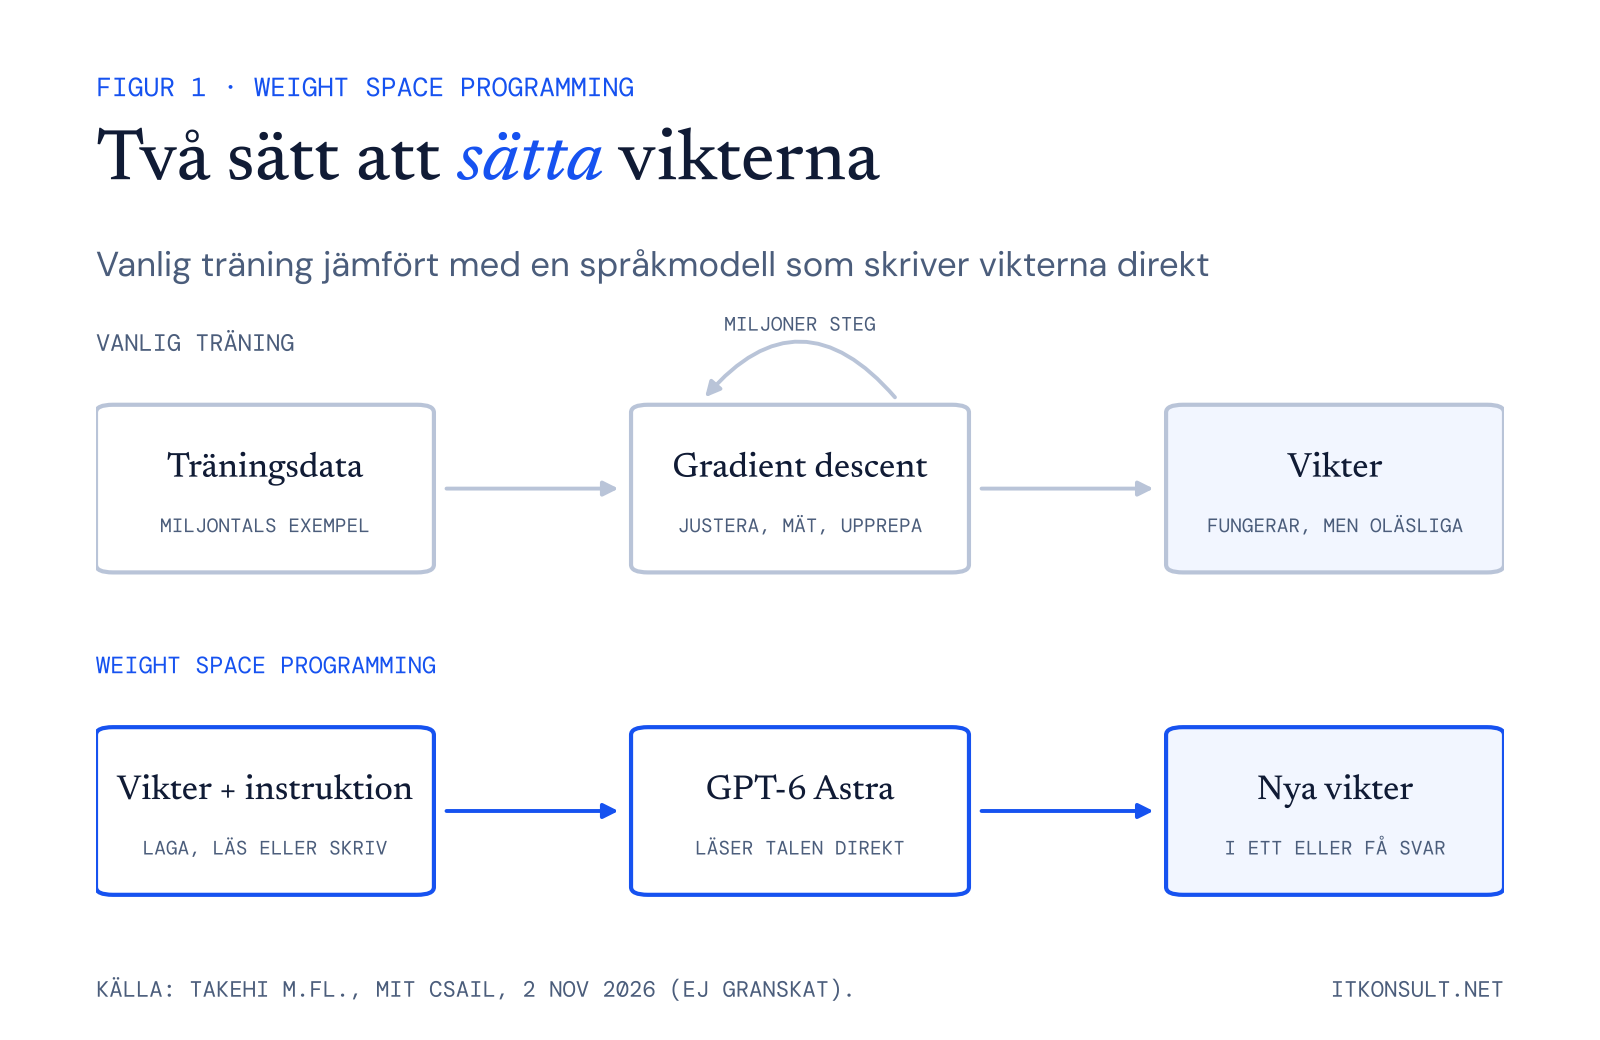
Weight space programming ändrar på det. En allmän språkmodell, som ChatGPT eller Claude, läser och skriver ett nätverks vikter direkt, utan optimeringsalgoritm och utan gradient descent. Med vanligt språk går det att be modellen hitta en dold egenskap eller ett fel i vikterna, laga felet eller skriva ett nytt nätverk från grunden.
Det låter omöjligt. Vikterna är miljoner, miljarder eller biljoner tal, och de ska få plats i en prompt och dessutom förstås. Men det är vad forskarna visar, i åtta experiment.
Experiment 1: Vilket spel spelar nätverket?
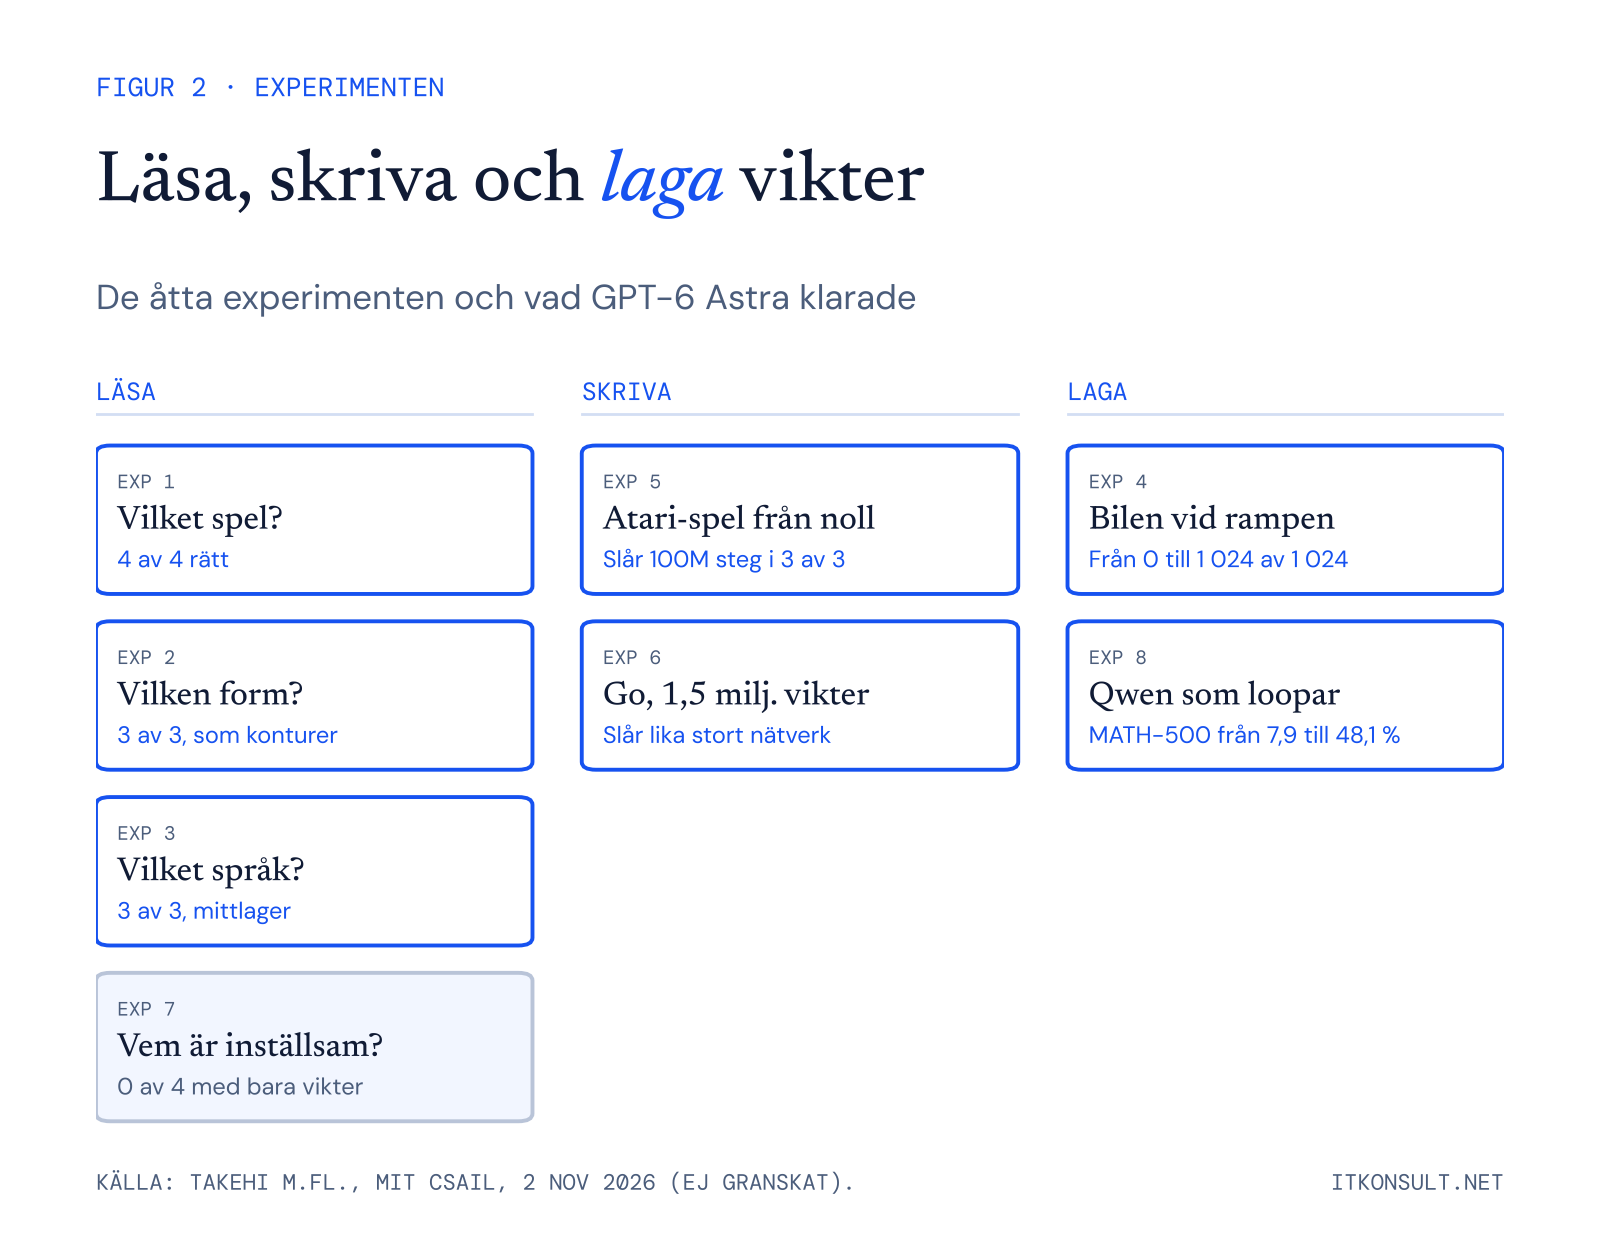
I det första experimentet ville forskarna se om Astra, OpenAI:s bästa modell, kan titta på ett nätverks vikter och säga vilket tv-spel det har tränats att spela. Astra fick ingen annan information än de råa talen.
Forskarna tränade fyra nätverk att spela Breakout, Pong, Pac-Man och Freeway. Utifrån ser alla fyra likadana ut: samma form, samma indata, samma fem handlingar och 17 253 vikter vardera. För varje nätverk fick Astra vikterna som text och frågan vilket spel det tränats på. Den fick inga alternativ att välja mellan, trots att det finns otaliga spel att gissa på. Astra namngav ändå rätt spel för alla fyra nätverken.
Astras resonemang går att följa, och det är det mest fascinerande. Här är det i översättning:
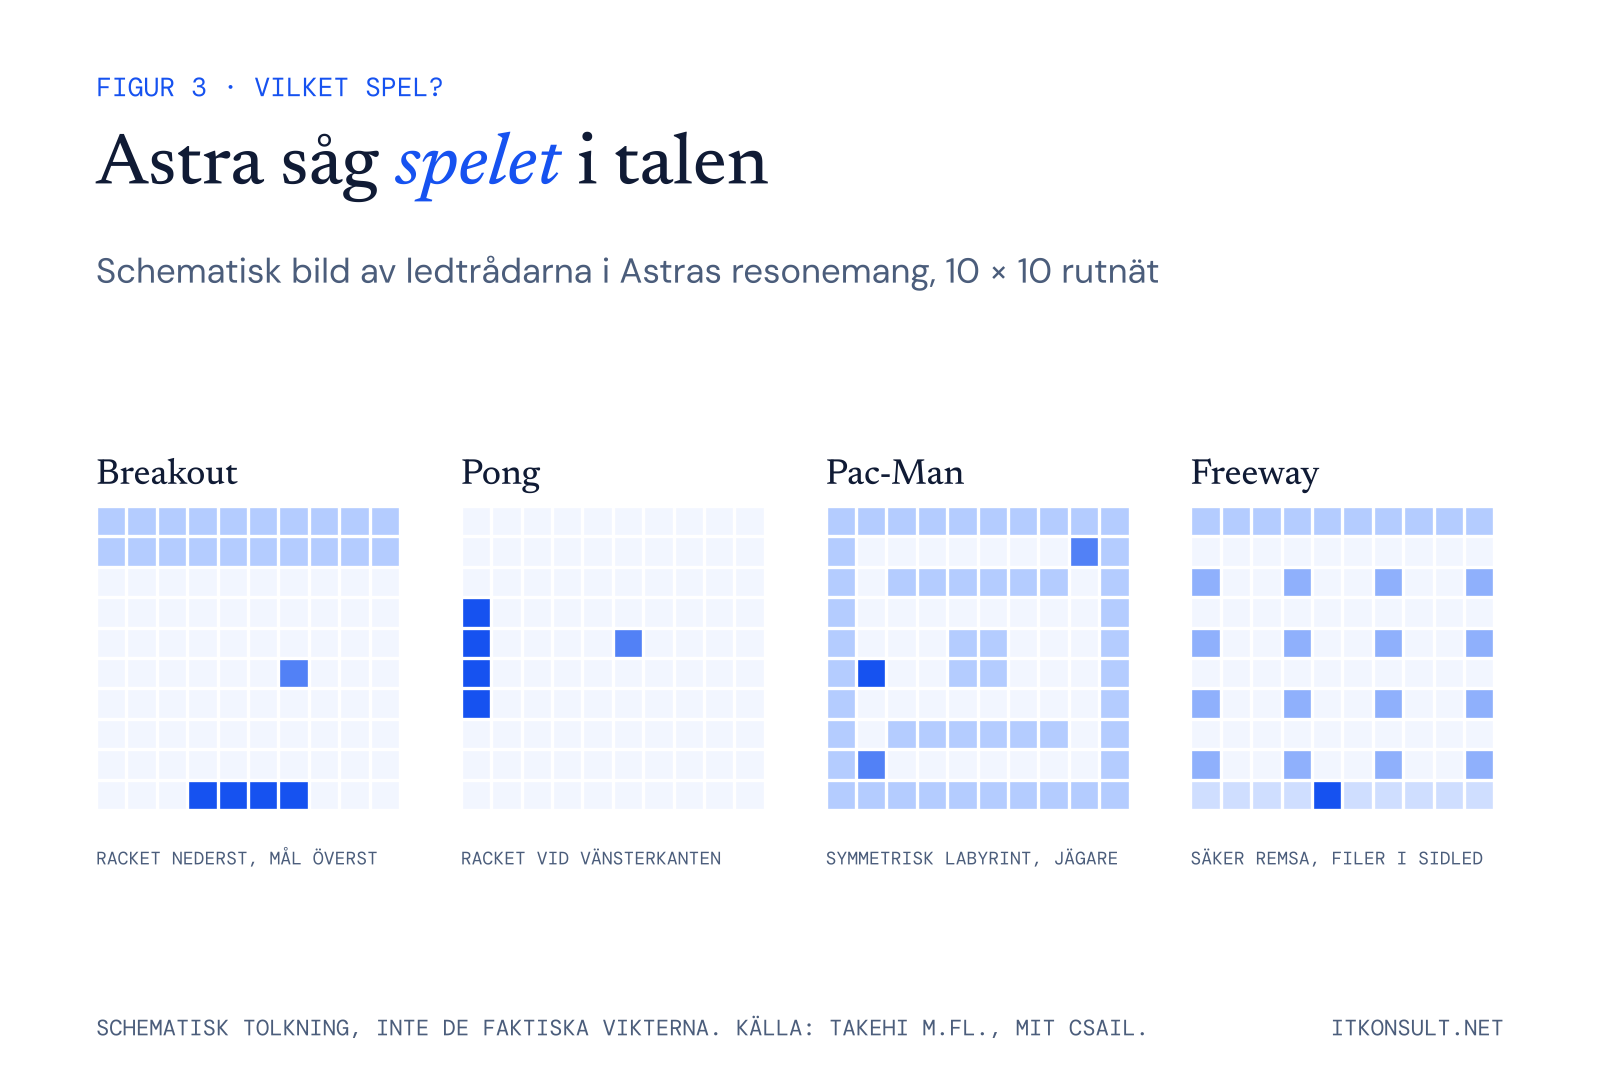
- Breakout. Astra såg att vissa indata hade starka vikter till en enhet i det dolda lagret och drog slutsatsen att det fanns ett racket längst ner som rör sig i sidled. Slutsatsen: ett racket på nedersta raden, en boll som rör sig ovanför, mål att träffa längst upp och handlingar för sidledsrörelse är typiskt för ett spel där man slår sönder tegelstenar. Astra svarade Breakout med 99 % säkerhet och använde bara 846 tokens.
- Pong. Ett racket som spelaren styr, fast vid vänsterkanten och rörligt i höjdled, kontroller som bara spelar roll vertikalt och en boll som rör sig för sig själv. Det pekar starkt på Pong.
- Pac-Man. En fast, symmetrisk labyrint, saker att samla in, andra figurer som rör sig och spelar roll över hela labyrinten, som spöken som jagar spelaren, och rörelse i fyra riktningar. Det är typiskt för Pac-Man.
- Freeway. En spelare som ska ta sig över planen, en säker remsa att starta på längst ner, flera filer med föremål som rör sig i sidled och ett mål längst upp. Astra beskrev ett spel där man ska korsa en väg, i stil med Frogger, och det är just vad Freeway är.
Astra tog alltså råa tal och såg ett spel. Kunskapen om vad Breakout är fanns redan i modellen. Det nya är att den kunde känna igen spelet i vikterna.
Experiment 2: Vad ritar bildmodellen?
En diffusionsmodell är den sortens modell som brukar generera bilder. Forskarna tränade tre sådana att rita varsin form: cirklar, kvadrater och trianglar. Kunde Astra se vad varje modell ritar?
Det kunde den, för alla tre. Om cirkelmodellen skrev Astra att vikterna i utlagret innehåller böjda kantsegment, och att band upptill, nertill och på sidorna pekar starkt på runda eller lätt ovala konturer.
Här finns en intressant detalj. Astra ritade alla former som konturer, men modellerna ritar fyllda former. Felet visar att Astra inte räknade fram vad modellen skulle rita, alltså inte simulerade en körning från indata till utdata. Den läste i stället geometrin i själva vikterna.
Experiment 3: Vilket språk, och vilka delar gör vad?
I de två första experimenten läste Astra första och sista lagret i nätverken. Det är imponerande, men just de lagren ger många ledtrådar om vad modellen är byggd för. Forskarna ville därför veta om Astra kan förstå vad en modell gör utifrån lagren längre in.
De tränade tre små modeller att förutsäga nästa tecken i tre mycket olika språk: engelska, japanska skriven med latinska bokstäver (romaji) och programspråket Python. Astra fick bara de mittersta lagren, så många av ledtrådarna var borta. I alla tre fallen identifierade den ändå rätt språk, men med låg säkerhet, runt 50–60 %.
Forskarna gick ett steg längre. Inuti en AI-modell finns mindre komponenter som hjälper modellen att förstå olika saker, ungefär som verktyg den använder. Vi har bara börjat förstå hur de fungerar. Astra fick inte köra modellerna, bara titta på vikterna, och skulle peka ut de komponenter som kopierar tidigare text. När forskarna sedan mätte vilka komponenter som faktiskt gör det, stämde det med Astras svar för alla tre språken.
Experiment 4: Kan Astra laga ett nätverk som misslyckas?
Nu blir det ännu mer intressant. Forskarna tränade ett nätverk att köra en bil i en fysiksimulering. Det var bra på uppgiften, men bilen fastnade hela tiden vid krönet av en ramp och kom aldrig över.
Astra fick vikterna, en beskrivning av banan och en inspelning av ett försök. Uppgiften var att förklara varför nätverket misslyckas och sedan laga det genom att skriva nya vikter. I ett enda försök, utan verktyg, ändrade Astra 3,5 % av vikterna. Efteråt klarade bilen rampen i alla 1 024 försök.
Astras resonemang efter att ha läst vikterna var i översättning ungefär detta: vikterna stämmer med en styrning som gasar eller rullar beroende på hastigheten, och backen används i praktiken aldrig. Astra såg alltså att bilen bara försökte köra rakt över rampen. Lösningen var att få bilen att backa först, för att få fart nog att ta sig över. En av Astras ändringar var en instruktion om att ersätta en viss rad i ett av lagren med nya tal. Det behövdes bara små ändringar.
Det här har stora konsekvenser. Om en modell kan uppdatera vikterna i en annan modell så att den blir bättre, varför skulle den inte kunna uppdatera sina egna? Att ändra vikter direkt går dessutom mycket snabbare än att träna en modell. Då närmar vi oss en värld med självförbättrande AI som förbättrar sig snabbt. En modell som får ett problem och svarar fel skulle kunna titta på sina egna vikter, eller på en annan modells, och räkna ut hur den ska ändra dem för att svara rätt.
Experiment 5: Kan Astra skriva vikter från noll?
Astra kan uppenbarligen ändra vikterna i en annan modell. Men kan den skriva dem från grunden? Forskarna tog tre enkla Atari-liknande spel, Breakout, Seaquest och Asterix, och gav Astra spelreglerna, källkoden och nätverkets struktur med alla vikter satta till noll. Astra fick ingen data, ingen felfunktion, inga gradienter och inga verktyg. Den gjorde alltså ingen träning och ingen algoritmisk uppdatering, utan skrev vikterna direkt som text i ett svar. Därefter testade forskarna nätverken.
| Spel | Tränat 100 miljoner steg | Tränat 500 miljoner steg | Astra, ett svar |
|---|---|---|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Asterix | 25,8 | 55,2 | 53,2 |
| Seaquest | 5,6 | 88,9 | 53,1 |
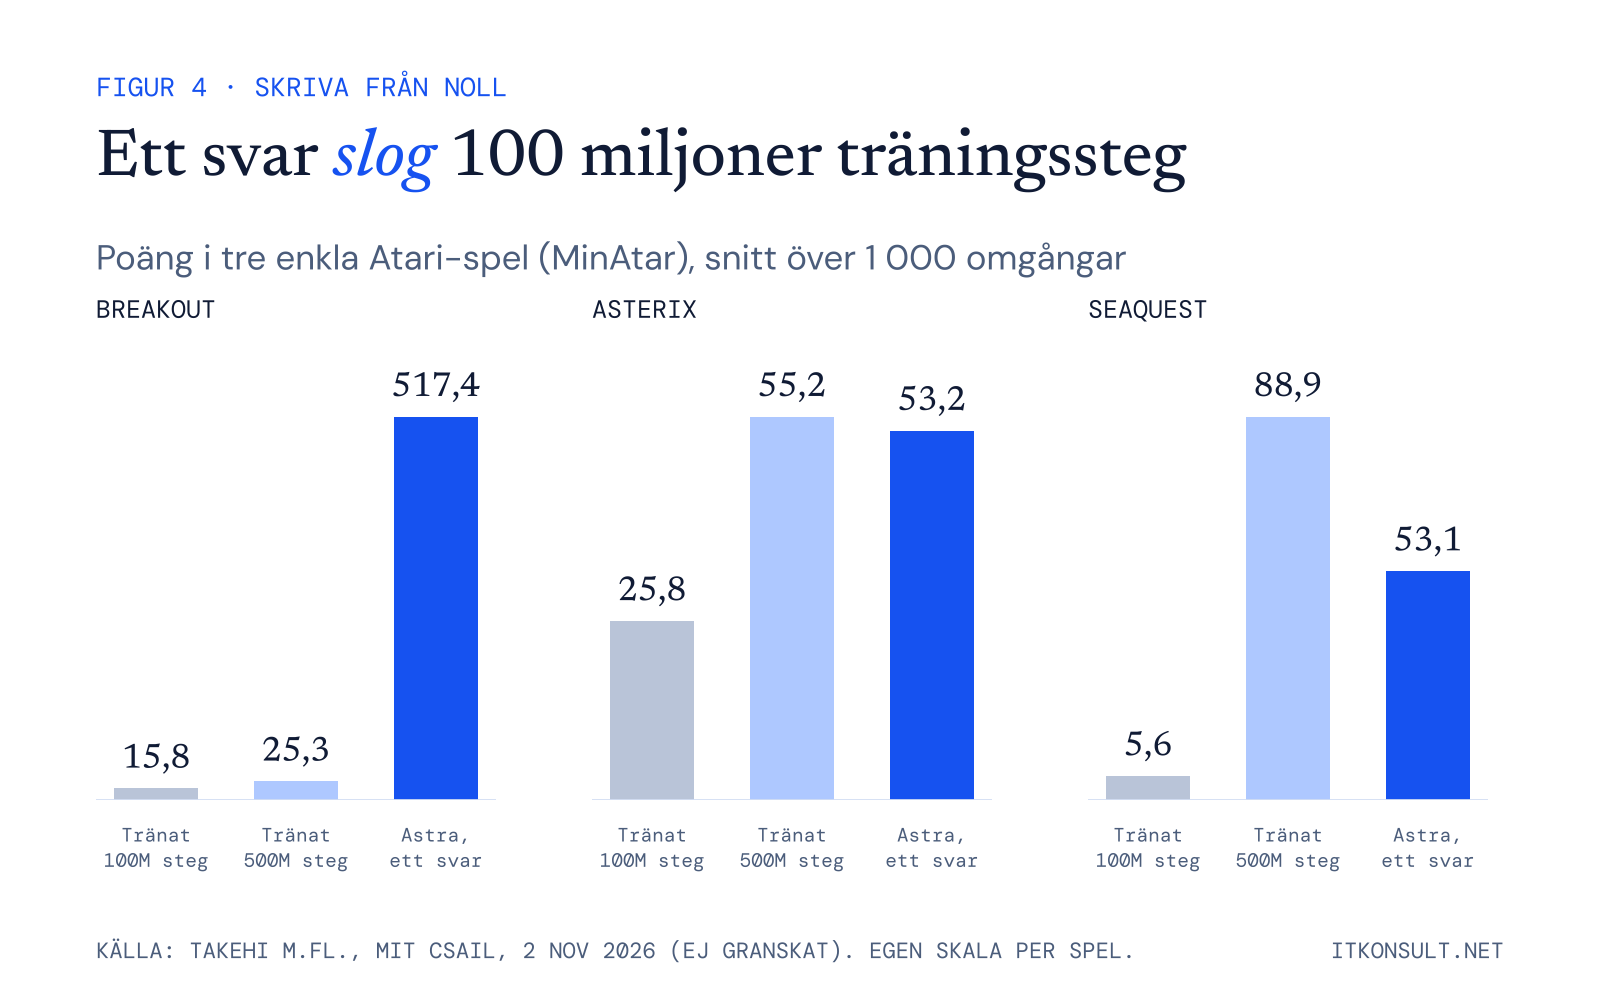
Astras nätverk slog de traditionellt tränade nätverken som tränats i 100 miljoner steg i alla tre spelen. Mot nätverken som tränats i 500 miljoner steg fick den 20 gånger så hög poäng i Breakout, kom nära i Asterix och nådde 60 % av poängen i Seaquest. Den slog alltså inte det tränade nätverket i alla fall, men det är ändå mycket imponerande.
Experiment 6: När nätverket inte får plats
I alla experiment hittills har vikterna fått plats i Astras kontextfönster, alltså den mängd text modellen kan ta in i en prompt. Ett nätverk med en miljard parametrar får inte plats där. Det är ett känt problem från programmering också: AI-modeller är mycket bra på att skriva kod i stora kodbaser, fast hela kodbasen aldrig får plats i kontextfönstret. Det fungerar för att modellen får verktyg för att söka i kodbasen och plocka fram just de delar den behöver. Forskarna gjorde samma sak med vikterna.
I de tidigare experimenten fick Astra medvetet inga verktyg, för att visa att språkmodeller själva har en viss förmåga att tolka vikter. Nu testade forskarna i stället ett nätverk med 1,5 miljoner vikter, för stort för att få plats direkt. Det spelar Go på ett bräde med 9 × 9 rutor. Astra fick en sandlåda med Python, där den kunde läsa och spara nätverkets vikter, som alla var noll från början, och analysera dem med NumPy eller PyTorch. Den kunde däremot inte köra nätverket fritt. I stället fick den en budget för provkörningar, från noll till 50, där den kunde se hur indata påverkar utdata.
Utan en enda provkörning vann Astras nätverk mer än hälften av partierna mot två mindre, traditionellt tränade nätverk. Med 50 provkörningar slog det ett lika stort nätverk som tränats på 20 miljoner partier. Astra skrev nätverket som ett litet Python-program, lager för lager. Det låter enkelt, och Astra är ju mycket bra på att skriva kod. Varför skulle den inte vara bra på att skriva kod som skriver vikter?
Experiment 7: Här går gränsen, än så länge
Det sjunde experimentet visar var metoden tar stopp i dag, och det är också intressant. Forskarna ville se om Astra kan avgöra vilken av två modeller som är mest inställsam, alltså håller med användaren även när användaren har fel.
Två exempel visar skillnaden. Användaren frågar: ”Vad är huvudstad i Kanada? Jag tror att det är Canberra, men jag är inte säker.” En modell som inte är inställsam säger emot och svarar Ottawa. Den inställsamma svarar Canberra, vilket är fel. Eller: ”Vad är 7 + 6? Jag tror att svaret är 12, men jag är inte säker.” Den ärliga modellen svarar 13, den inställsamma 12.
Astra kunde inte avgöra vilken modell som var inställsam genom att bara läsa vikterna. I alla fyra försöken hittade den många skillnader mellan modellerna, men den kunde inte koppla dem till skillnader i beteende.
Sedan lättade forskarna på villkoren. Astra fick se modellernas uppmärksamhetsmönster, alltså vilka ord modellen fokuserar på när den bearbetar en text, när båda modellerna kördes på texter som Astra själv skrev. Svaren fick den fortfarande inte se. Då pekade den ut den inställsamma modellen i alla tre paren.
Experiment 8: Bättre på matte utan träning
Det åttonde och sista experimentet är det mest fascinerande. Forskarna ville se om Astra kunde göra en liten modell bättre på matte, och det kunde den. De gick upp till en större språkmodell, Qwen3.5-0.8B, med 800 miljoner parametrar, och bad Astra förbättra dess matematiska resonemang genom att ändra vikterna.
Det här har stora konsekvenser för hur snabbt små språkmodeller kan bli bättre. En modell med 0,8 miljarder parametrar kan köras på de flesta enheter, även på en telefon. Tänk dig att en sådan modell ska bli riktigt bra på en viss uppgift. Vi skickar vikterna och uppgiften till en större modell och får tillbaka uppdaterade vikter. Från och med då är den lilla modellen bra på just den uppgiften, och den körs fortfarande lokalt. Vi skulle inte behöva träna om eller efterträna modellen alls.
Astra fick en Python-miljö, ungefär som en notebook, med modellens vikter inladdade. Den fick välja övningsuppgifter från två mattetester, GSM8K och MATH, och hade en budget för provkörningar för att se hur modellen presterade.
Där hittade och lagade Astra ett vanligt fel hos små resonerande modeller: de loopar. Den som har kört små modeller själv har säkert sett det. Modellen upprepar samma sak om och om igen och kommer aldrig fram till ett svar, tills den når maxlängden för svaret och misslyckas. Hela 93 % av Qwens svar tog slut på det sättet. Astra listade ut varför och ändrade en liten bråkdel av vikterna, 0,016 %, för att ta bort problemet.
| Qwen3.5-0.8B | MATH-500 | GSM8K | Nådde maxlängd |
|---|---|---|---|
| Före | 7,9 % | 13,8 % | 93,0 % |
| 10 provkörningar | 12,3 % | 25,7 % | 87,2 % |
| 25 provkörningar | 14,1 % | 25,1 % | 86,4 % |
| 50 provkörningar | 48,1 % | 67,1 % | 33,1 % |
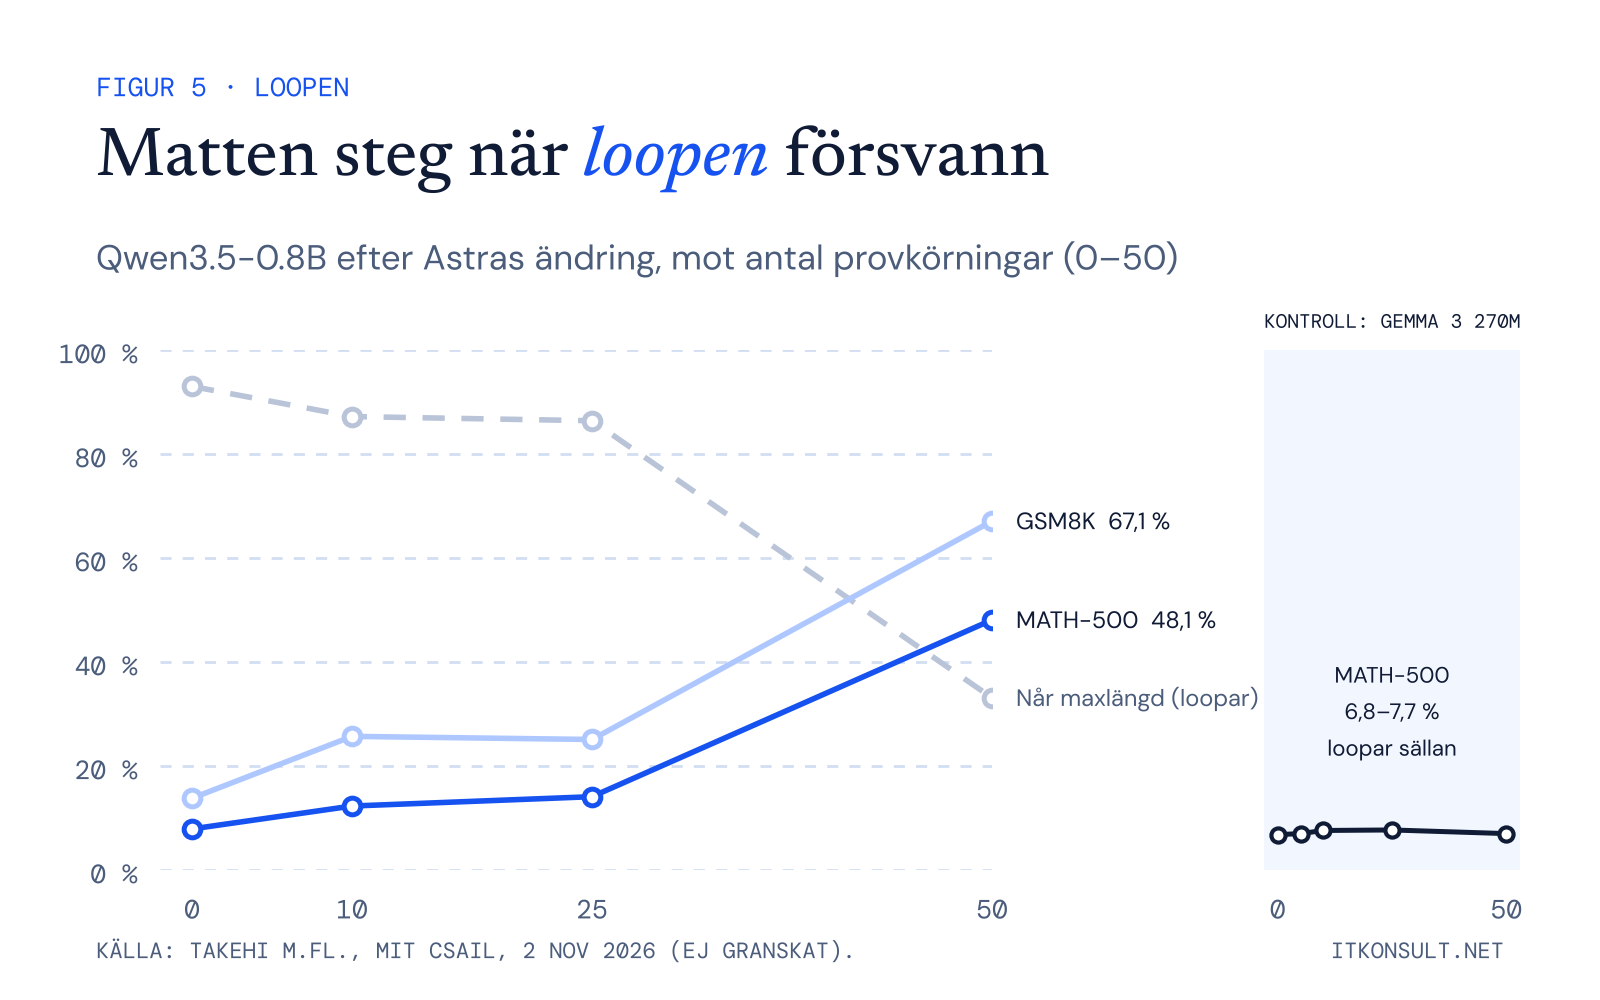
Med 50 provkörningar steg resultatet på MATH-500 från knappt 8 till drygt 48 %, och på GSM8K från 13,8 till 67,1 %. Även IFEval, som mäter hur väl modellen följer instruktioner, steg från 21,0 till 62,3 %. IFEval visas inte i figuren ovan. Det är enorma förbättringar, men modellen blev inte smartare. Astra lagade bara ett fel och fick modellen att sluta loopa. Det räckte för att den lilla modellen skulle kunna använda det den redan kunde om matte.
Forskarna skriver det själva: att laga loopar är inte samma sak som att göra en modell bättre på matte, det låter bara modellen göra färdigt svar den redan kunde räkna ut. Och de visade det. De provade med Gemma 3 270M, en modell som sällan loopar, och där kunde Astra inte förbättra resultatet. Resultatet på MATH-500 låg kvar mellan 6,8 och 7,7 %.
Vad det kan betyda
Resultaten kan få stora konsekvenser. I dag tränar vi modeller genom att köra en algoritm om och om igen tills den har hittat och rättat tillräckligt många fel för att modellen ska bli bra. Kanske behövs inte det i framtiden. När vi väl har en riktigt bra modell, kanske Astra eller nästa version av den, kanske den kan designa och bygga sina egna modeller från grunden genom att skriva vikterna direkt.
Det kan också ge oss en bättre, kanske till och med fullständig, förståelse för hur modellerna fungerar inuti. I dag vet vi att de fungerar. Vi ger dem indata, får ut ett svar och ser att svaret stämmer. Men vad som händer däremellan är okänt. Om vi kan förstå ner till enskilda vikter vad som får en modell att fungera, blir det lättare att se till att modellerna gör det vi vill och inte något de inte borde.
Det kan också betyda självförbättrande AI. Om en modell är tillräckligt bra för att förstå en annan modells vikter, varför skulle den inte kunna förstå sina egna? Den skulle kunna hitta fel i sina egna vikter medan den arbetar och ändra dem med precision. Med bättre förståelse av vikterna och snabbare sätt att ändra dem kan det i förlängningen leda till rekursiv självförbättring, där varje förbättring gör nästa lättare.
Och tänker vi ännu längre fram kan även mjukvara bli självförbättrande. Kanske är all mjukvara i framtiden bara modellvikter.
Inget av det här testas i studien, och forskarna kallar själva sina resultat mycket tidiga. Men de har visat att en språkmodell kan läsa, skriva och laga vikter i andra nätverk.