Analys · 3 november 2026
AI blir billigare per token – men räkningen växer ändå
Johan Öhman Saldes
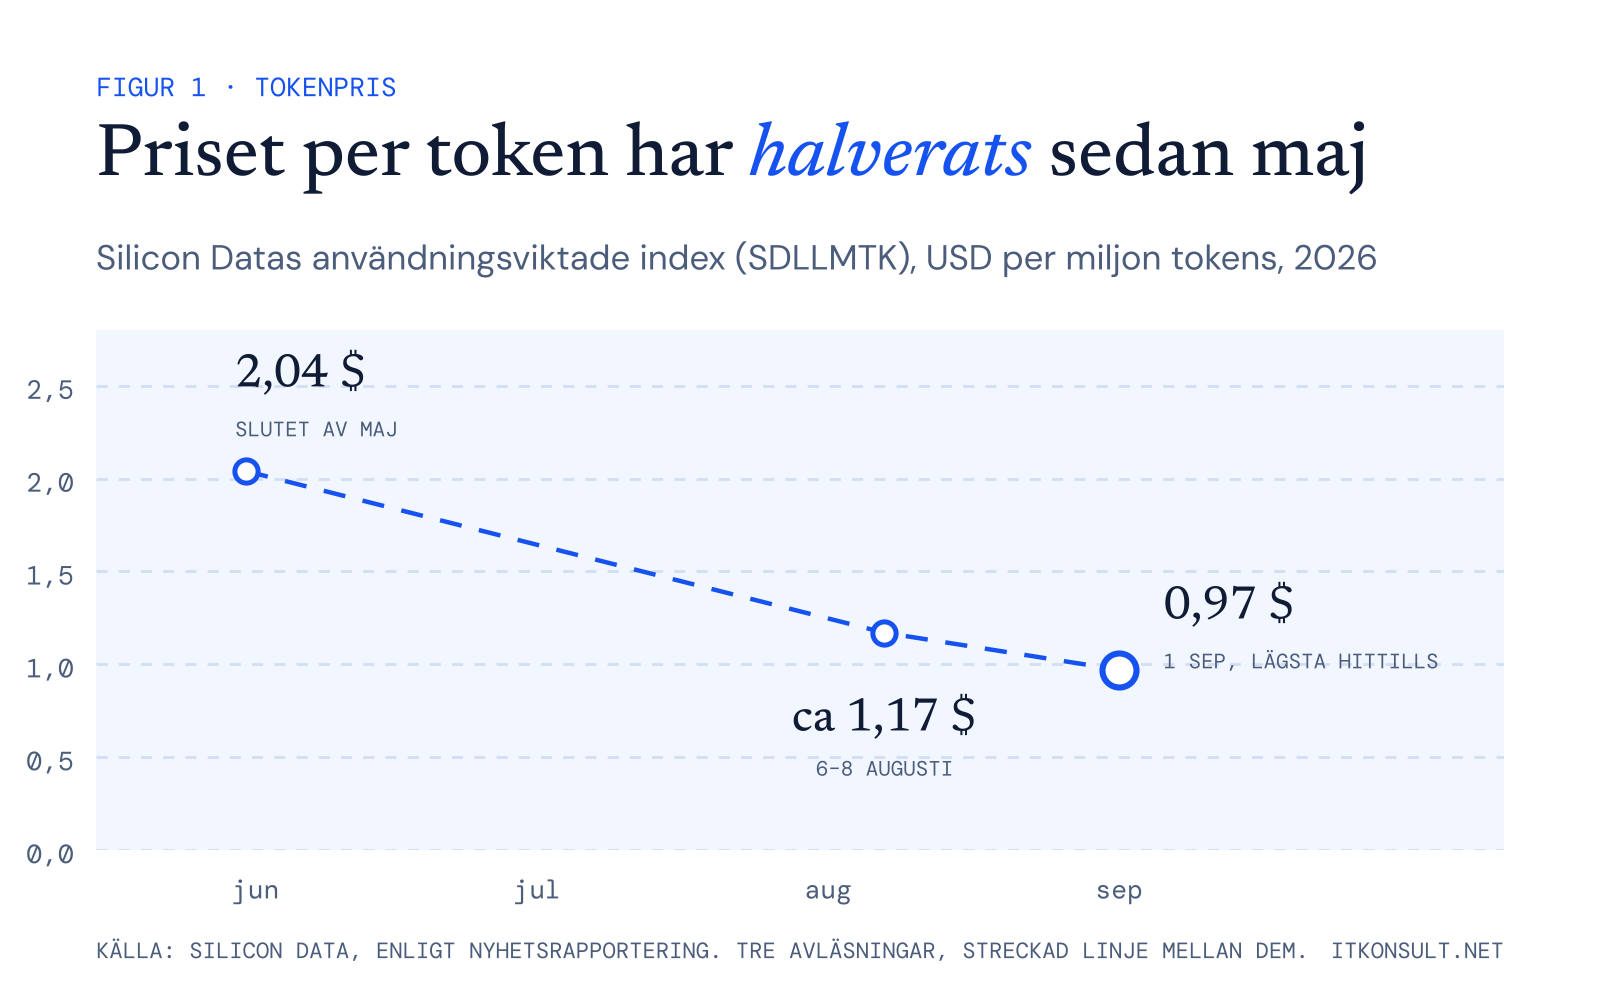
Priset per AI-token har halverats sedan maj 2026. Ändå växer räkningen för de flesta som använder AI, eftersom AI-agenter gör av med allt fler tokens. Det är förbrukningen, inte priset, som avgör vad AI kostar ditt företag.
Många räknar med att billig AI är en tillfällig rea. Big Tech lägger hundratals miljarder dollar på AI-infrastruktur 2026, chippen tappar snabbt i värde och AI-bolagen måste så småningom gå med vinst. Då borde priserna stiga.
Men när ett företag använder AI via API betalar det per token, alltså per ord eller del av ett ord som modellen läser eller skriver. Och det priset faller fortfarande. Signalerna om dyrare AI finns, men de handlar om annat än priset per token.
Det som talar för dyrare AI
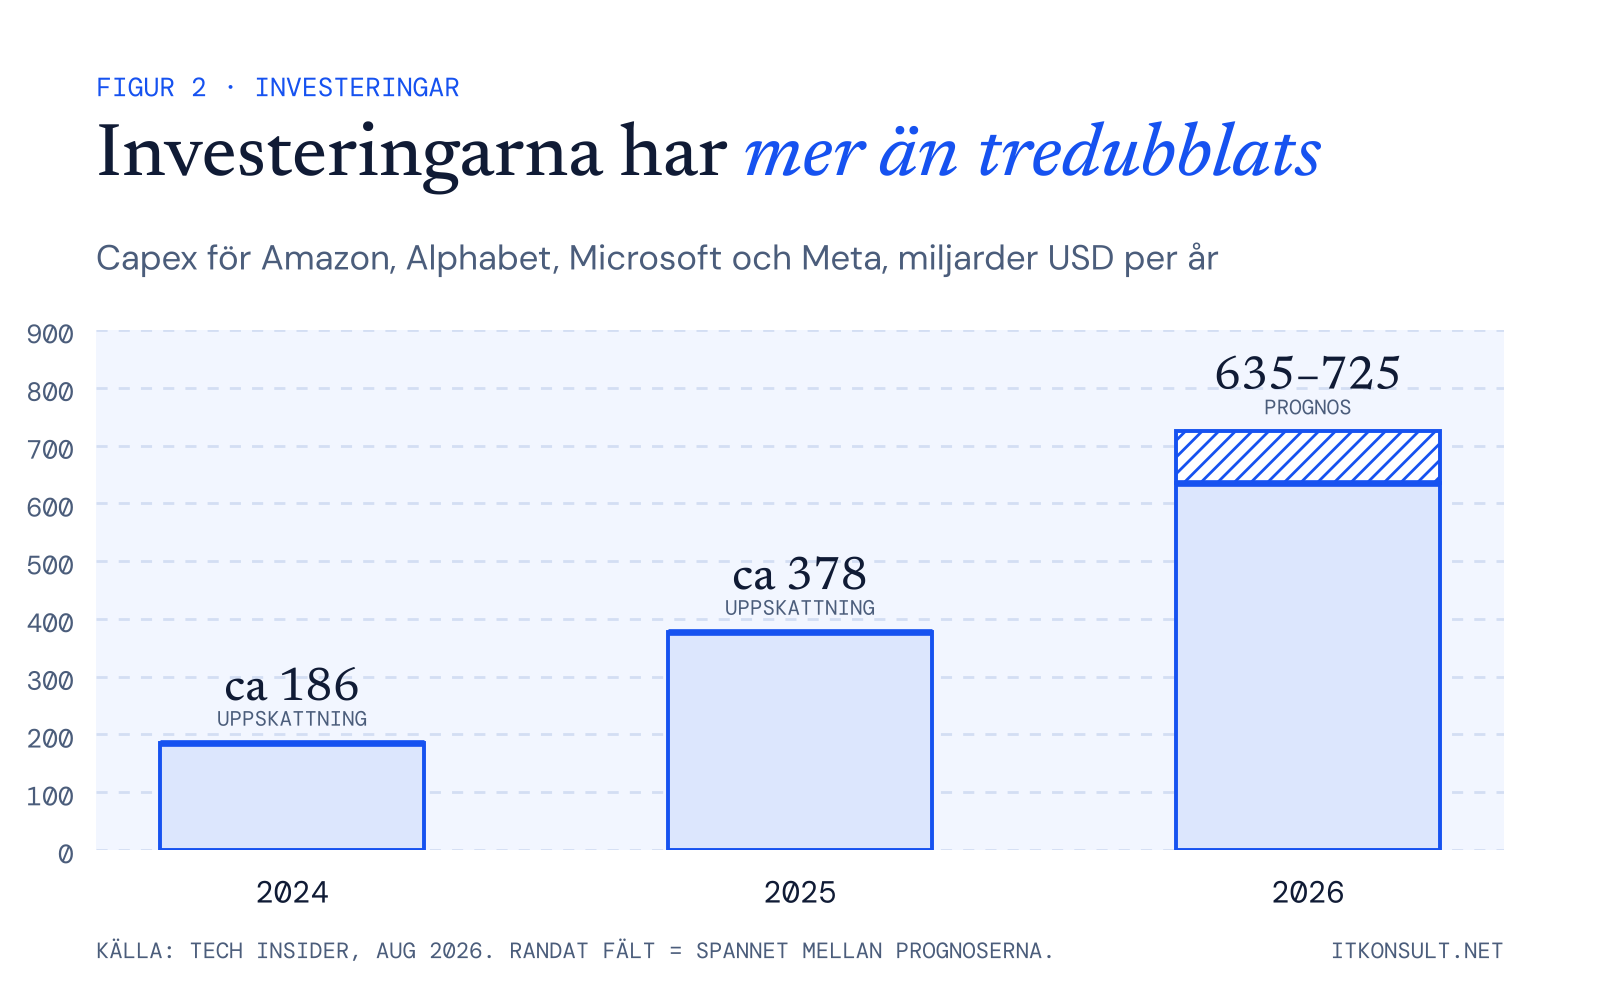
Investeringarna är enorma. JPMorgan räknar med att hyperskalarnas investeringar landar på omkring 800 miljarder dollar 2026. Amazon, Alphabet, Microsoft och Meta står ensamma för ungefär 725 miljarder.
Prismodellerna ändras också. I april 2026 gick OpenAI över till pris per token för Codex, och Anthropic tar nu betalt av företagskunder med en fast avgift per användare plus API-pris för förbrukningen. Dessutom kostar GPT-5.5 dubbelt så mycket per token som GPT-5.4.
Det är verkliga signaler, men de säger mindre än det verkar. Användningsbaserad debitering flyttar kostnaden mellan kunderna: de som använder mycket betalar mer, de som använder lite betalar mindre. Och att en ny toppmodell är dyr säger inget om vad det kostar att leverera en token.
Därför blir AI-tokens billigare
Att Nvidia släpper en ny chipgeneration varje år slår mot balansräkningen hos den som äger de gamla chippen. Men varje generation sänker också kostnaden för att leverera en token. Enligt Nvidia har leverantörer som kör Blackwell sänkt kostnaden per token upp till tio gånger jämfört med föregående generation, Hopper.
Pengar som redan är investerade styr inte priset. Det gör kostnaden för nästa token och vad konkurrenterna tar betalt. Det syns i marknadspriset: Silicon Datas användningsviktade index låg på 2,04 dollar per miljon tokens i slutet av maj 2026 och på 0,97 dollar den 1 september 2026, den lägsta nivån sedan indexet startade i december 2025.
Öppna modeller håller dessutom emot. Flera kinesiska modeller har öppna vikter och kan köras på egna servrar eller hos en europeisk leverantör, så att ingen data skickas till Kina. Höjer de amerikanska bolagen priset för mycket kan kunderna byta.
AI-agenter får räkningen att växa
Jag tror ändå att de flesta organisationers AI-räkning kommer att växa, eftersom vi använder allt mer. AI-agenter som arbetar i många steg gör av med mångfalt fler tokens än en fråga i en chatt. Goldman Sachs räknar med att agentisk AI kan öka tokenförbrukningen 24 gånger fram till 2030.
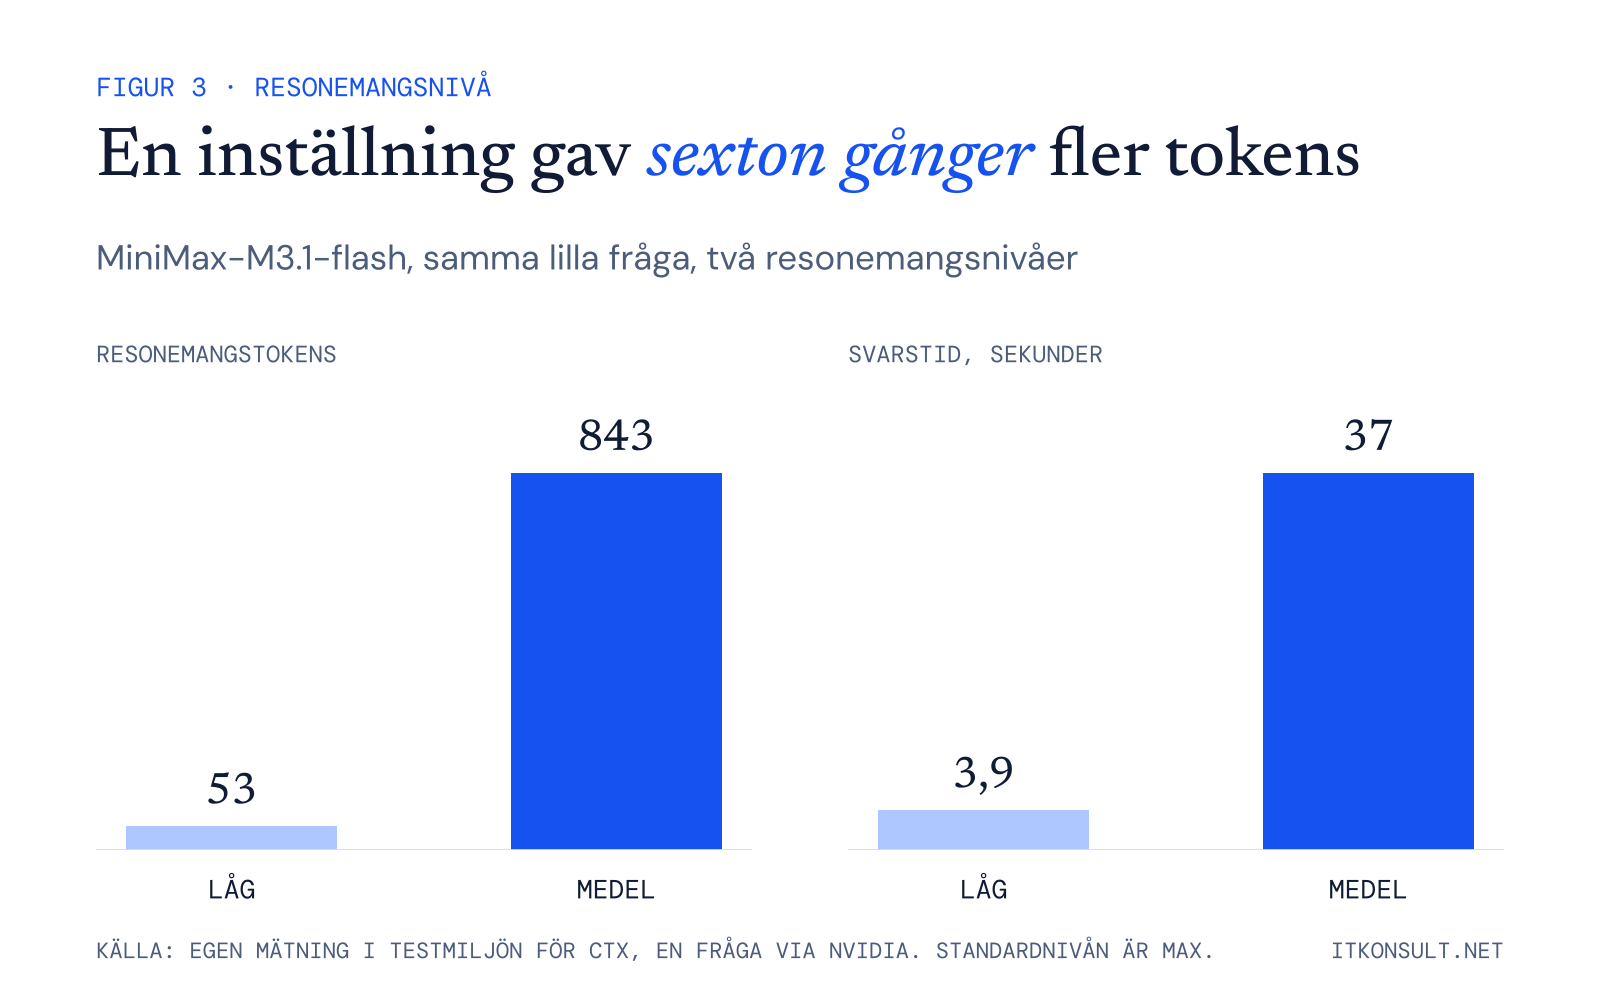
Hur många tokens det blir beror också på inställningar som är lätta att missa. När jag testade mitt verktyg ctx, som ger AI-kodagenter kontext om en kodbas, körde modellen MiniMax-M3.1-flash med högsta resonemangsnivå som standard. Ungefär 94 % av det modellen skrev var resonemang, och varje tur tog 10–17 minuter. På samma lilla fråga gav låg nivå 53 resonemangstokens på 3,9 sekunder och medelnivå 843 tokens på 37 sekunder. En enda inställning gav alltså ungefär sexton gånger fler tokens.
Gartner bedömer dessutom att leverantörernas lägre kostnader inte förs vidare fullt ut till företagskunderna, och att de mest avancerade modellerna kräver betydligt fler tokens än dagens vanliga tillämpningar. Toppmodellerna kan alltså behålla ett högt pris samtidigt som förra årets kapacitet blir nästan gratis.
Frågan för ett företag är därför inte vad en token kostar, utan hur många ni gör av med och på vad.
Så sänker ni AI-kostnaden: tre steg
Experimentera gärna nu, men budgetera inte för kraftiga prisökningar per token. Gör i stället så här:
- Mät förbrukningen per uppgift. Fakturan visar vad ni betalar, inte varför. Först när ni ser tokens per uppgift vet ni var pengarna går.
- Välj modell och inställning efter uppgiften. Många uppgifter klarar sig med en mindre modell eller en lägre resonemangsnivå. Använd toppmodellerna där de gör skillnad.
- Bygg så att ni kan byta modell. Kan ni flytta en uppgift till en billigare eller öppen modell påverkas ni mindre av en prisändring hos ett enskilt bolag.
Billig AI ser ut att bli ännu billigare. Det som kan vara ett fönster är billig tillgång till de allra bästa modellerna, och det är där budgeten behöver styras. Allt det här är i grunden MLOps: att mäta, utvärdera och kunna byta komponenter utan att bygga om allt.
Så kan jag hjälpa ditt företag
Jag är MLOps- och AI-ingenjör med mer än tio år som utvecklare, och jag hjälper företag att bygga, driftsätta och följa upp AI-system.
Mätningen av resonemangsnivån kom från en testmiljö jag har byggt för ctx. Alla modellanrop går genom en egen gateway som håller API-nycklarna och loggar varje anrop. Varje försök blir en körning i MLflow med tokens, antal turer, tidsåtgång och resultat, och Grafana visar helheten. Samma slags uppsättning kan jag bygga för er.
Jag erbjuder
- Kostnadsgenomgång. Jag instrumenterar er applikation med MLflow Tracing, så att ni ser tokens, tidsåtgång och kostnad per uppgift, funktion och modell. Sedan pekar jag ut vad som går att sänka.
- Utvärdering och modellval. Jag sätter upp testfall i MLflow, med mätvärden och språkmodeller som bedömare. Då vet ni om en billigare modell eller en lägre inställning räcker innan ni byter.
- Gateway och utbytbara modeller. En gemensam ingång som håller nycklarna och loggar varje anrop gör ett leverantörsbyte till en konfigurationsändring. För era egna modeller gör MLflows modellregister samma sak med alias, till exempel champion.
- Drift och uppföljning. CI/CD i GitHub Actions, driftsättning i Kubernetes med Terraform och övervakning i Grafana, så att kostnad, svarstid och kvalitet syns över tid.
- Utbildning och workshops. För team som vill bygga upp kunskapen själva. Jag undervisar också i MLOps på yrkeshögskola.
Vill ni veta vad era AI-anrop faktiskt kostar per uppgift, eller om en mindre modell skulle räcka? Hör av er via itkonsult.net, så börjar vi med att mäta.
Källor
- AI Capex to Hit $1 Trillion – IO Fund (JPMorgans uppskattning)
- Big Tech AI infrastructure capex 2026 – Tech Insider
- Simon Willison om prisändringarna hos OpenAI och Anthropic
- Cloud accelerator pricing for LLM inference – Nvidia
- LLM Token Expenditure Index (SDLLMTK) – Silicon Data
- Preiskrieg auf dem KI-Markt (indexet på 0,97 dollar) – it-daily
- Gartner forecasts 90% drop in LLM inference costs by 2030 – HPCwire
- AI token costs force rethink at Uber and Microsoft (Goldman Sachs) – eeNews Europe
- MLflow för generativ AI: spårning, utvärdering och AI Gateway
- MLflow: Token Usage Tracking for LLM Applications
- ctx på GitHub